Мінімум discoverability
Google рекомендує, щоб кожна важлива сторінка мала link хоча б з однієї іншої сторінки сайту.
Технічне SEO · Внутрішня перелінковка · Data-driven architecture
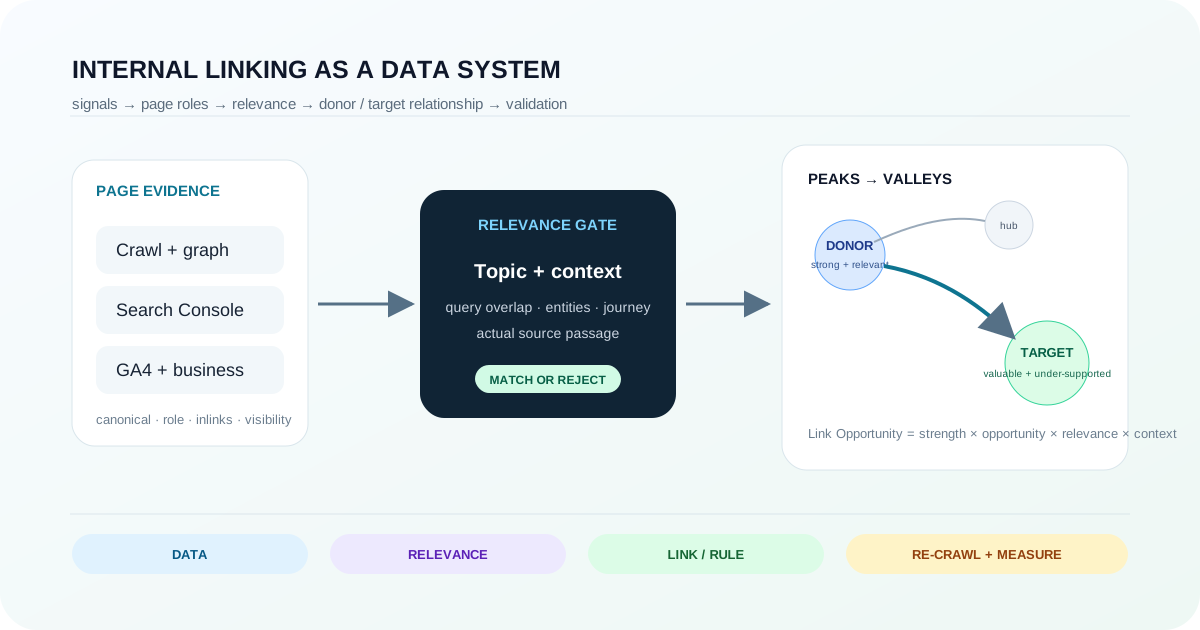
Внутрішня перелінковка краще працює як система архітектури, а не quota. Поєднайте crawl data, Search Console, GA4 та page roles, щоб знайти сильні donors і цінні under-supported targets; створюйте зв’язки лише за тематичної та контекстної релевантності, а потім масштабуйте й валідуйте процес.
Коротка відповідь
Будуйте internal linking із page roles + evidence + relevance. Crawl data показує структуру, Search Console — search opportunity, GA4 — onsite/business context; donor→target pair має сенс лише тоді, коли source справді сильний, target заслуговує підтримки, а relationship тематично й контекстно природний. AI може прискорити пошук candidates, але не замінює evidence та human validation.
Google рекомендує, щоб кожна важлива сторінка мала link хоча б з однієї іншої сторінки сайту.
Google не задає універсальної ідеальної кількості посилань для сторінки.
API повертає clicks, impressions, CTR та average position разом із запитаними dimensions.
Search Console описує до-переходу поведінку; Analytics — взаємодію після візиту.
01 · Архітектура
Корисне питання звучить не “де вставити ще один лінк?”, а “які зв’язки між сторінками повинна явно відображати архітектура сайту?”.
Google описує links одночасно як спосіб знаходити нові сторінки для crawl і як сигнал, що допомагає визначати релевантність сторінок. Тому одиниця роботи у внутрішній перелінковці — це зв’язок між двома сторінками, а не quota для окремої URL.
На сайті можуть бути тисячі internal links і водночас слабка архітектура. Важлива сторінка може залишатися глибоко в структурі, template modules можуть генерувати багато низькоконтекстних links, а нова URL — бути в sitemap, але майже не брати участі у внутрішньому графі.
Кастомна схема
Hub, сильні donor pages і under-supported targets утворюють мережу. Однакова кількість links може створити зовсім різну архітектуру залежно від того, що саме вони з’єднують і наскільки природний контекст.
Google також рекомендує, щоб кожна важлива для вас сторінка мала хоча б одне внутрішнє посилання з іншої сторінки сайту. Це варто трактувати як мінімальну умову discoverability, а не як завершену стратегію: одна URL може бути reachable і все одно залишатися глибокою, ізольованою від topic cluster або погано поясненою контекстом.
02 · Дані
Практична рекомендація для перелінковки починається з нормалізованого списку URL, де технічний стан поєднаний із search demand, onsite value та роллю сторінки.
Базова модель — один рядок на одну intended canonical page. Crawler дає структурний шар; Search Console — performance у Google Search; Analytics — поведінку після переходу та бізнес-результати. Backlink і log data можна додати для великих або складних сайтів. Мета — не “найбільша таблиця”, а можливість пояснити кожну рекомендацію даними.
| Шар | Що збираємо | Яке питання це закриває | Обмеження |
|---|---|---|---|
| Crawl / architecture | status, canonical, indexability, depth, inlinks, outlinks, template, page role | Чи може URL безпечно брати участь у графі? Чи вона ізольована/перелінкована надмірно? | Crawler бачить ваш crawl path, а не всю історію crawl Google. |
| Search Console | clicks, impressions, CTR, average position, query ↔ page relationships | Де вже є visibility, прихований search demand або сторінка близька до сильнішої позиції? | Position і CTR — контекст, а не самостійний “quality score”. |
| GA4 | sessions, engaged sessions, engagement rate, bounce rate, average session duration, key events, revenue за потреби | Чи сторінка підтримує корисний user journey і бізнес-результат після переходу? | Behavior metrics залежать від implementation і purpose сторінки; не перетворюйте їх на ranking proxy. |
| External / business | referring domains/authority estimate, priority, margin, freshness, owner | Які сторінки важливі стратегічно та які donors мають додаткову зовнішню підтримку? | Third-party authority metrics — оцінки, а не метрики Google. |
| Logs / crawl observations | bot requests, frequency, response patterns | Як bots реально звертаються до важливих templates та URL classes? | Logs показують requests, але не ranking value або intent. |
Розгорніть redirects, зведіть відомі duplicates до canonical URL, яку аналізуєте, і додайте template/page-role labels. Excluded URLs збережіть окремим diagnostic set, а не видаляйте без сліду.
КритерійОдин аналітичний рядок відповідає одній intended canonical page; excluded/duplicate states збережені як evidence.
Вивантажте page-level Search Analytics, а де потрібно — page × query rows. Збережіть clicks, impressions, CTR та average position за чітко визначений період.
ШляхSearch Console API → Search Analytics: query
КритерійЗафіксовано date range, search type і dimensions; кожну метрику можна простежити до API/export.
Додайте organic sessions і ті engagement/conversion metrics, які відповідають задачі сайту. Зафіксуйте acquisition filter, яким визначали Google organic traffic.
ШляхGA4 → Reports або Data API
КритерійAnalytics metrics явно позначені як onsite/user evidence і не використовуються як “link equity” чи прямий ranking score.
Збережіть dataset, час crawl та measurement window до зміни links. Саме цей snapshot використовуйте для re-crawl і post-release comparison.
КритерійCandidate list можна відтворити зі збереженого baseline, а не лише з dashboard, який постійно змінюється.
Для дуже великих properties Bulk data export Search Console у BigQuery спрощує page/query joins і регулярний scoring. Для меншого сайту достатньо API/export + crawler: складність pipeline має відповідати масштабу задачі.
03 · Пріоритизація
“Вершини й низини” — це модель пріоритизації: сильні релевантні donors підтримують цінні under-supported targets. Сильна сторінка не стає donor для будь-якої слабкої URL.
Вершина — потенційний donor: технічно стабільна, discoverable, добре вбудована у структуру сторінка, яка має сенс у темі конкретного target. Низина — потенційний target: сторінка з цінністю або потенціалом, але з недостатньою підтримкою графа. Високий/низький traffic сам по собі не визначає ці ролі.
Для кожної donor→target пари я б ставив чотири окремі питання: наскільки сильний donor? наскільки цінна opportunity у target? наскільки сторінки тематично споріднені? і чи є на source page природний контекст, де link реально допомагає читачеві?
Кастомна схема
Performance і graph signals допомагають знайти peaks/valleys, але topical relevance та реальний context source page вирішують, чи вартий зв’язок посилання.
| Компонент | Можливі evidence | Що підсилює score | Що має його знижувати |
|---|---|---|---|
| Donor strength | visibility, internal inlinks, crawl depth, external support, page role | стабільна canonical page з meaningful visibility та graph connectivity | redirect/noindex, застарілий контент, слабка роль, нерелевантний template |
| Target opportunity | impressions, position band, business priority, under-linking, depth, query coverage | цінна сторінка з demand/strategic role та слабкою підтримкою | неясний purpose, duplication, unresolved indexability, intentionally excluded URL |
| Topical relevance | query overlap, entities, taxonomy, page-role relationship, semantic similarity | спільний task/topic/entity set і логічний user journey | лише lexical similarity без змістовного зв’язку |
| Context fit | реальний paragraph, section, component/navigation state | читачеві корисно перейти на target саме тут | link потрібен лише для score або exact-match keyword |
04 · Індексація
Неіндексована URL стає пріоритетним target лише після того, як ви довели, що вона взагалі повинна бути в індексі та що internal support пов’язана з проблемою.
Інтуїтивне правило звучить так: “не індексується = найбільша низина”. Я б змінив його на “не індексується = найвищий diagnostic priority”. Search Console прямо зазначає, що статус not indexed не завжди є проблемою: частина URL навмисно excluded, duplicate, alternate canonical або просто не має бути search landing page.
Почніть із purpose. Якщо це duplicate, parameter state, utility/private page або інша URL не для Search — приберіть її з target pool замість спроб “підсилити”.
КритерійДля кожного non-indexed candidate є явне рішення “should index: yes/no” з причиною.
Використайте Page Indexing та URL Inspection. Перевірте status, crawl allowance, noindex, canonical selection і live availability.
ШляхSearch Console → URL Inspection
КритерійВідомі indexability/canonical state; відсутність в індексі не трактується як generic internal-link issue.
Якщо URL noindex, canonicalized на іншу сторінку, broken, duplicate або технічно ненадійна — спочатку виправте або свідомо залиште цей стан. Internal links не повинні суперечити intentional exclusion strategy.
КритерійСторінка повертає потрібний status, directives і canonical relationship до пріоритетної роботи з links.
Коли URL корисна, indexable і canonical, під’єднайте її з релевантних crawlable pages і повторіть inspection/re-crawl. Перелінковка тут — один remediation step, а не універсальний fix індексації.
КритерійTarget reachable через crawlable HTML links із релевантних сторінок, а новий шлях присутній у rendered output.
05 · Релевантність
Semantic similarity — хороший фільтр, але фінальне рішення має проходити перевірку в реальному контексті source page.
У guidance Google є дуже практичний критерій: anchor text має бути descriptive, reasonably concise і relevant як до source, так і до destination; слова навколо link також створюють context. Тому оцінювати треба не лише embeddings двох сторінок, а й конкретний source passage.
Механізм обирайте після того, як relation зрозумілий. Contextual editorial link добрий, коли source text уже вводить target concept. Breadcrumbs описують ієрархію. Hub/category modules — membership. Navigation — persistent importance. Related-content modules допомагають exploration, але не повинні перетворюватися на випадковий блок “SEO links”.
06 · Кількість links
Кількість links є наслідком функції сторінки та information architecture, а не site-wide quota.
Google прямо пише, що магічної ідеальної кількості links для сторінки немає. Тому правила “30 links per page” або “додати п’ять contextual links у кожну статтю” — слабкі defaults. Product category, довгий research guide і login screen мають різні navigation needs.
Для automation все одно можна задати operational cap, наприклад “повертати не більше N candidates на source для human review”. Це workflow constraint для контролю noise/QA, а не SEO threshold і не твердження про те, скільки links “хоче Google”.
07 · Масштабування
На великому сайті правильним fix часто є один template rule, а не сотні ручних вставок.
Manual linking перестає масштабуватися, коли однаковий relationship повторюється на product pages, documentation, location pages, programmatic landing pages або multilingual inventory. Перед automation individual insertions згрупуйте candidate pairs за relationship type. Якщо 750 product pages потребують link на відповідний category hub, справжнім artifact може бути одне протестоване template rule.
| Поле правила | Приклад питання | Навіщо це потрібно |
|---|---|---|
| Eligible source roles | Які templates можуть створювати relationship? | Не дає global rule потрапити в нерелевантні page types. |
| Eligible target roles | Які canonical/indexable targets можуть його отримувати? | Не допускає redirects, noindex та duplicate variants у production links. |
| Relevance gate | Який taxonomy/entity/query relationship має бути true? | Робить relevance перевірюваною до deployment. |
| Placement mechanism | Contextual passage, breadcrumb, hub, related module чи navigation? | Кодує architecture intent, а не просто генерує href. |
| Operational cap | Скільки candidates система повертає на review? | Контролює review noise; це не Google link-count rule. |
| Validation | Що re-crawl повинен довести після release? | Робить automation reversible і testable. |
08 · AI-assisted workflow
AI корисний для classification, semantic matching і context inspection, якщо evidence contract чіткий, а production changes залишаються контрольованими.
На сайті з десятками тисяч URL donor-target matrix занадто велика для ручного порівняння. AI може класифікувати page roles/topics, cluster entities, ранжувати semantically plausible pairs, перевіряти реальний donor passage і формувати review queue. Але evidence для рекомендації все одно має походити з crawl, Search Console, Analytics, URL state та source content.
Кастомна схема
Agent отримує нормалізовані site data і constraints, ранжує candidates, повертає explainable suggestions та передає implementation людині або контрольованому rule. Re-crawl і measurement закривають цикл.
{
  "sourceUrl": "https://example.com/guides/technical-seo/",
  "targetUrl": "https://example.com/guides/internal-linking/",
  "relationship": "technical-seo -> internal-linking methodology",
  "scores": {
    "donorStrength": 0.82,
    "targetOpportunity": 0.76,
    "topicalRelevance": 0.91,
    "contextFit": 0.85
  },
  "evidence": {
    "sourceStatus": 200,
    "targetIndexable": true,
    "targetImpressionsWindow": "defined in baseline dataset",
    "matchingSection": "Site architecture and crawl paths"
  },
  "suggestedAnchor": "internal linking architecture",
  "action": "human-review",
  "confidence": "medium"
}
Це лише illustrative schema. Числові значення — внутрішні normalized scores, а не Google metrics; агент має повернути underlying evidence, щоб reviewer міг відхилити рекомендацію.
09 · Валідація
Implementation завершена лише тоді, коли новий relationship є у rendered output, target лишається валідним, а baseline можна порівняти з post-release data.
Переконайтеся, що source повертає 200, містить crawlable <a href> на intended canonical target і не створює redirect/noindex hops.
КритерійSource→target edge є у crawlable HTML/rendered output; URL states відповідають rule.
Порівняйте depth, inlink counts, orphan/near-orphan state та rule coverage з baseline. Перевірте, що automation не створила unrelated link explosion.
КритерійTarget cohort отримав потрібну структурну підтримку без неочікуваних cross-cluster edges.
Порівнюйте clicks, impressions, CTR, position і page/query relationships за однаковим post-release window. Не робіть causal claims за однією URL або кількома днями volatility.
ШляхSearch Console → Performance або Search Analytics API
КритерійДо/після використовують однакові metric definitions і filters, target cohort збережений.
Перевірте, чи linked journey дає корисні sessions, engagement або business events. Очікуйте, що clicks і sessions відрізнятимуться, бо Search Console та Analytics мають різні системи й визначення.
КритерійSearch і onsite metrics показані поруч із джерелом, а не злиті в один undocumented success score.
| Рівень | Pass evidence | Що вимірювати | Обмеження |
|---|---|---|---|
| Technical | crawlable source href; intended target status/canonical; no broken hops | edge exists, target state, depth, inlinks | доводить implementation, а не ranking impact |
| Search | consistent target cohort before/after | impressions, clicks, CTR, position, query coverage | на Search performance одночасно впливає багато факторів |
| User / business | linked journeys залишаються корисними | sessions, engaged sessions, key events, revenue за потреби | metrics залежать від instrumentation і page purpose |
| System quality | rule генерує релевантні candidates з низьким rejection/error rate | coverage, reviewer rejection, duplicate/invalid candidate rate | внутрішній QA metric, не search-engine metric |
Для більшої causal confidence використовуйте controlled rollout, якщо architecture дозволяє: змінюйте один relationship class, фіксуйте source/target cohorts, не поєднуйте реліз із великими template/content changes і запишіть release date. Навіть тоді organic movement краще називати evidence consistent with intervention, а не доказом, що один link спричинив конкретну ranking change.
10 · Operating model
Масштабована система явно пояснює, чому link додається, чому інший candidate відхиляється і як результат буде перевірений.
Практичний принцип: не переносіть “link equity” сліпо зі сторінок із великими числами на сторінки з малими числами. Спочатку вирішіть, чого заслуговує target; потім знайдіть релевантний donor і правильний mechanism; після цього перевірте, що relationship існує й залишається корисним.
Головне обмеження — attribution. Internal linking змінює architecture, discovery paths і context, але Search performance залежить від багатьох систем одночасно. Метод найсильніший тоді, коли спочатку створює кращу, explainable site structure — навіть до того, як ви побачите ranking change.
Першоджерела та документація
Кожне змінне твердження про пошукову систему, браузер, інтерфейс або технічну поведінку в матеріалі прив’язане до актуального першоджерела.
Потрібна допомога з діагностикою та впровадженням?
Metricum Lab може поєднати crawl architecture, Search Console/analytics evidence та business priorities у donor-target map, template rules і validation plan, не змішуючи інформаційну методологію з комерційним audit workflow.
Переглянути аудит та оптимізацію internal linking