Етапи обробки Google
Google описує JavaScript processing як crawling, rendering та indexing — це не один синхронний fetch.
JavaScript SEO · Rendering · Діагностика індексації
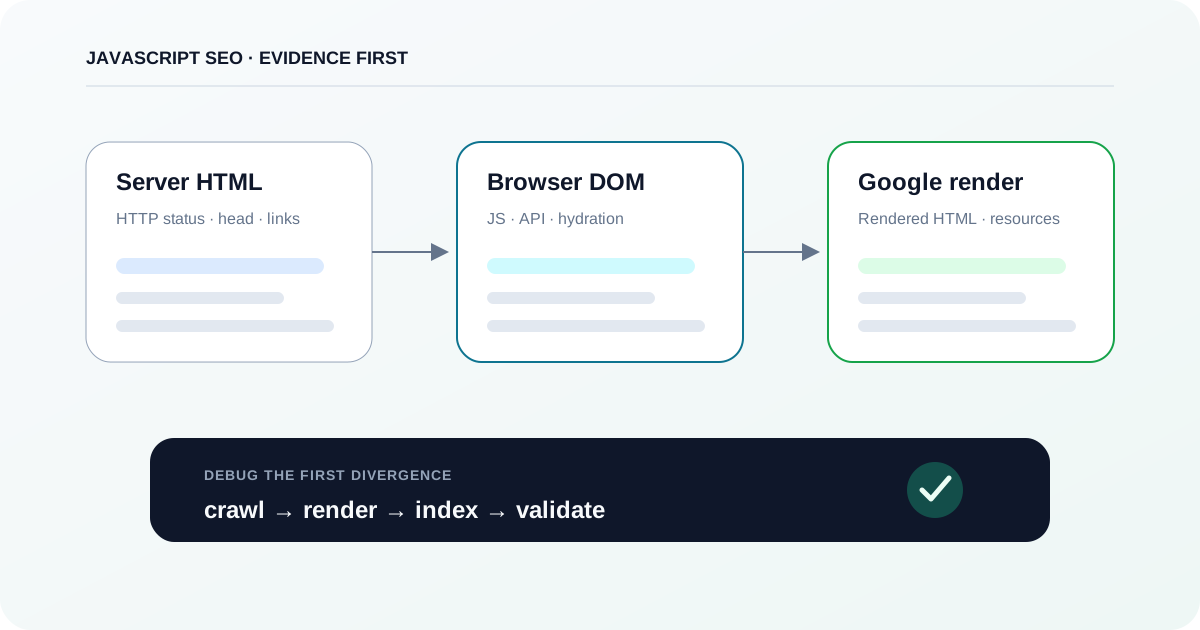
Я рекомендую спочатку визначити та переконатися на якому рівні / етапі контент сторінки розходиться з очікуваним контентом. Порівняйте HTTP response, browser-rendered DOM і Google-rendered evidence; виправляйте найперший шар, де губиться критичний контент, посилання або індексаційний сигнал.
Коротка відповідь
Не варто починати з питання чи вміє Google виконувати код вашого framework. Візьміть один репрезентативний URL і порівняйте три артефакти: raw HTTP response, DOM після виконання JavaScript у браузері та Google-rendered evidence з URL Inspection або Rich Results Test. Перший шар, де зникає критичний контент, links, canonical/robots або коректна status behavior, визначає наступний тест.
Google описує JavaScript processing як crawling, rendering та indexing — це не один синхронний fetch.
За документацією Google, сторінки з HTTP 200 потрапляють у rendering queue, якщо robots directive не блокує indexing; для non-200 rendering може бути пропущений.
Google зазвичай парсить посилання як anchor element з href; script-only псевдопосилання не є надійною заміною.
Crawling infrastructure Google за замовчуванням обробляє перші 15 MB файлу, але окремі краулери та типи файлів можуть мати інші ліміти. Це інфраструктурна межа, а не універсальний Googlebot HTML threshold.
01 · Локалізуйте проблему
JavaScript SEO проблему простіше локалізувати, якщо зберегти три артефакти одного URL: server HTML, browser-rendered DOM і Google-rendered output.
Порожній view-source: сам по собі не доводить, що сторінка не може бути проіндексована. Так само ідеальна сторінка у вашому браузері не доводить, що Google отримав той самий контент. Моя базова модель — порівняння трьох станів. Стан 1 — HTTP response до client JavaScript. Стан 2 — DOM після виконання scripts та data fetch у браузері. Стан 3 — HTML і resource evidence з Google rendering tools. Виправляйте найраніший стан, де зникає потрібний сигнал: наступні симптоми часто є лише наслідком.
02 · Побудуйте модель pipeline
У JavaScript pipeline Google є окремі етапи та черги. Discovery failure — не те саме, що render failure, а успішний render не гарантує indexing.
Google Search описує три основні фази для JavaScript pages: crawling → rendering → indexing. Googlebot спочатку отримує URL, якщо robots.txt дозволяє crawl, і витягує links із response. Сторінки з HTTP 200 потім потрапляють у rendering queue, якщо robots directive не забороняє indexing; очікування може тривати секунди або довше. Headless evergreen Chromium виконує JavaScript, після чого Google ще раз аналізує rendered HTML для links і використовує цей output під час indexing. Тому «Google fetched URL» і «Google indexed rendered content» — різні твердження.
Кастомна схема
Один URL створює різні докази на crawl, render та index stages. Кожен етап може мати окрему failure mode і потребує свого артефакту.
03 · Зафіксуйте baseline
Server response — це контрольний зразок. Зафіксуйте status, directives, canonical, ключовий контент і crawlable links до аналізу client-side app.
Запитайте точний canonical URL без залежності від browser state. Збережіть фінальний status після redirects і перевірте robots-related HTTP headers.
ШляхTerminal → curl -I https://example.com/path
КритерійПотрібний indexable URL приходить на очікуваний final URL із коректним HTTP status; немає неочікуваного X-Robots-Tag, що блокує indexing.
Збережіть response body, щоб пізніше порівняти його з rendered output. Перевірте title, canonical, robots meta, H1/primary content і кілька representative internal links.
ШляхTerminal → curl -sS https://example.com/path -o server.html
КритерійSEO-сигнали, які архітектура має віддати через server rendering, дійсно присутні та коректні в server.html.
Відкрийте сторінку з уже активним DevTools, щоб cache не приховав first-load behavior. Виберіть main document і перегляньте Headers та Response.
ШляхChrome DevTools → Network → reload → [main document] → Headers / Response
КритерійDevTools показує той самий final status та очікуваний initial HTML, що й незалежний curl capture.
Для intermittent hydration/bundle issues форсуйте first-load request замість діагностики кешованого успіху.
ШляхChrome DevTools → Network → long-press Reload → Empty Cache And Hard Reload
КритерійDocument, scripts і data успішно завантажуються на cold load без нового critical blocking failure.
URL='https://example.com/products/42'

curl -sS -L -D response-headers.txt "$URL" -o server.html

printf '\nStatus chain and headers saved to response-headers.txt\n'
printf 'Raw response HTML saved to server.html\n'

# Spot checks; вони не замінюють повний аналіз HTML.
grep -i -m1 '<title' server.html || true
grep -i -m1 'rel="canonical"' server.html || true
grep -i -m1 'name="robots"' server.html || true
Потрібні curl і стандартні shell tools. Це capture evidence, а не DOM parser: client-generated content тут не з'явиться. Висновки треба звірити з rendered DOM і Google-rendered output.
04 · Відтворіть у браузері
Rendered DOM може виглядати коректно, але залежати від крихких API calls, state, blocked resources або script-only navigation. Зберігайте dependency chain разом із DOM evidence.
Знайдіть distinctive phrase з primary content, canonical link і кілька representative internal links після завершення роботи app.
ШляхChrome DevTools → Elements → Ctrl/Cmd+F
КритерійCritical content і SEO elements існують у rendered DOM та не приховані за наступною user action.
Якщо контенту немає в server HTML, але він з'являється пізніше, визначте API/data request та його Initiator. Перевірте status, response payload і залежність від auth, cookies чи client state.
ШляхChrome DevTools → Network → Fetch/XHR → [request] → Headers / Response / Initiator
КритерійRequired data request успішний на clean load і не потребує state, недоступного crawler-у.
Hydration mismatch, uncaught exception або blocked module можуть зупинити app до створення critical subtree.
ШляхChrome DevTools → Console
КритерійНемає uncaught error або failed critical dependency, що блокує main content, metadata чи links.
Не тестуйте тільки переходом із home. Завантажте deep URL напряму, адже краулери відкривають URL незалежно один від одного.
ШляхNew Incognito window → paste deep URL → open DevTools → reload
КритерійDeep route повертає коректний content/status без залежності від попереднього SPA state, localStorage чи cookies.
WRS не зберігає localStorage, sessionStorage та HTTP cookies між page loads. Якщо route стає повним лише після попереднього in-app переходу, звичайна browser session може приховувати crawler-visible bug. Representative routes потрібно тестувати як незалежні entry points.
05 · Звірте Google evidence
Browser parity необхідна, але недостатня. Google's rendering tools дають rendered HTML, resource evidence та JavaScript failures.
URL Inspection допомагає зрозуміти збережений/indexed стан і canonical/indexability signals для точного URL у вашій Search Console property.
ШляхSearch Console → URL Inspection → inspect URL
КритерійЗафіксовані indexed state, last crawl evidence та canonical/indexability result до запуску fresh test.
Запустіть live test і відкрийте tested-page evidence. Порівняйте distinctive content phrase, link targets, canonical/robots, screenshot та failed resources із browser baseline.
ШляхSearch Console → URL Inspection → Test Live URL → View tested page → HTML / Screenshot
КритерійGoogle live render містить critical content і crawlable links, а required first-party resources завантажуються без помилок.
Google у JavaScript troubleshooting guide рекомендує Rich Results Test як інший спосіб перевірити loaded resources, console output і rendered DOM. Structured data — не єдина причина застосовувати його під час rendering diagnosis.
ШляхRich Results Test → URL → Test URL → rendered-page details
КритерійPublic Google render відтворює expected critical DOM або показує resource/console failure для подальшої перевірки.
06 · Локалізуйте root cause
Кожна причина має бути falsifiable hypothesis. Корисне питання не «JavaScript поганий для SEO?», а «який сигнал відсутній, на якому шарі і чому?».
Кастомна схема
Порівняйте один critical signal у server HTML, browser DOM і Google-rendered HTML. Перший missing layer звужує набір можливих причин і визначає наступний тест.
| Симптом | Ймовірна причина | Тест | Рекомендований fix | Валідація |
|---|---|---|---|---|
| У server HTML лише app shell; у browser content є | CSR залежить від JavaScript + data fetch | Порівняти server.html, Elements і Google-rendered HTML | Зробити critical content надійно renderable; якщо dependency крихка — SSR/prerender/hybrid | Critical content є у Google-rendered HTML на representative routes |
| Links працюють по click, але crawler не знаходить destinations | Script-only navigation або anchor без href | Перевірити rendered DOM на <a href> | Віддавати реальні crawlable anchors; client routing — enhancement | Destination URLs присутні як href у rendered HTML |
| Browser page indexable; Google render показує noindex | Initial robots meta або X-Robots-Tag відрізняється | Перевірити raw response + headers до JS | Віддавати потрібний robots directive у initial response | Server і Google-rendered directives збігаються |
| Після hydration неправильний або multiple canonical | Client code мутує/додає conflicting canonical | Порівняти source head і rendered head | Prefer stable HTML canonical; якщо потрібен JS — лише одне стабільне значення | У rendered HTML рівно один intended canonical |
| Missing product повертає 200 app shell | Client-side soft 404 | Direct request до missing route + URL Inspection | Meaningful server status або real 404/noindex error state | Missing URL більше не виглядає як звичайна 200 content page |
| Below-fold content відсутній у Google render | Lazy loading чекає scroll/click | Google-rendered HTML + browser test без interaction | Завантажувати relevant content, коли він visible; не вимагати explicit user action | Content з'являється без click/scroll dependency |
| Deep route працює після навігації, але не direct load | App залежить від попередніх cookies/storage/session | Відкрити deep URL у fresh Incognito | Public crawlable content має бути self-contained для кожного URL | Fresh direct load рендерить той самий critical content |
| Google render ніби використовує старий JS | Aggressive crawler/WRS caching + assets без fingerprint | Порівняти requested asset URLs і deployed hashes | Content fingerprinting для versioned JS/CSS | Google test завантажує current asset version |
07 · Оберіть architecture свідомо
Rendering strategy — trade-off, а не ranking switch. Для SEO потрібен стабільний crawlable/indexable output; продукт також має latency, cacheability, server cost та interactivity constraints.
Google і далі радить server-side або pre-rendering, оскільки це швидше для users/crawlers і не всі bots виконують JavaScript. У документації dynamic rendering bot-specific rendering уже названий workaround, а не long-term solution; замість нього рекомендовані SSR, static rendering або hydration. Для hybrid app я б віддавав search-critical route state через SSR або prerendering, де це можливо, а client-side залишав hydration та enhancement.
Кастомна схема
Почніть із search-critical content та freshness requirements, а потім оберіть найпростішу модель, що робить initial route надійним і не ламає product constraints.
08 · Зафіксуйте implementation contract
Надійна реалізація — це коли кожен important URL є справжнім entry point із crawlable navigation, meaningful status та deterministic critical content.
<nav>
  <a href="/products" data-route>Products</a>
  <a href="/services" data-route>Services</a>
</nav>

<script type="module">
  document.addEventListener('click', (event) => {
    const link = event.target.closest('a[data-route]');
    if (!link || event.metaKey || event.ctrlKey) return;

    event.preventDefault();
    const url = new URL(link.href);
    window.history.pushState({}, '', url.pathname);
    renderRoute(url.pathname);
  });
</script>
Illustrative framework-neutral pattern. Ключова SEO-вимога — real <a href>; History API enhancement не має скасовувати direct server handling для destination URL.
import { RenderMode, ServerRoute } from '@angular/ssr';

export const serverRoutes: ServerRoute[] = [
  { path: 'products/**', renderMode: RenderMode.Server },
  { path: 'guides/**', renderMode: RenderMode.Prerender },
  { path: 'account/**', renderMode: RenderMode.Client },
];
Illustrative configuration за актуальною Angular SSR documentation. Реальний вибір залежить від data freshness, auth, deployment і caching. Перед production-copy перевірте exact API для вашої встановленої Angular version.
09 · Закрийте validation loop
One-URL live test недостатній для template-level change. Валідуйте різні route types, зберігайте artifacts і контролюйте ті самі invariants після releases.
Запустіть той самий server capture, browser DOM check і Google live render, якими було доведено initial failure. За можливості змінюйте одну hypothesis за раз.
Шляхcurl + Chrome DevTools + Search Console URL Inspection
КритерійРаніше missing critical signal присутній на всіх required layers і не з'явився новий directive/status mismatch.
Перевірте хоча б один fresh direct URL для кожного суттєво іншого route mode/template: SSR, prerendered, CSR-only, parameterized та error routes, якщо вони є.
ШляхRelease QA matrix → route class → representative URLs
КритерійКожен route class проходить однакові content, link, status, canonical і robots acceptance rules.
Використовуйте Search Console crawl/indexation reporting і, якщо доступно, verified server/edge logs. Client analytics сам по собі не є повним журналом Googlebot/WRS activity.
ШляхSearch Console → Settings → Crawl stats; Page indexing; server/edge logs
КритерійУ monitored segment немає release-linked spike у fetch errors, unintended exclusions або втрати discovery priority routes.
Практичний принцип: rendering вважається перевіреним, коли один search-critical contract витримує independent HTTP fetch, clean browser render і Google render — а не коли framework demo виглядає правильно. Якщо три стани збігаються, переходьте до indexation та quality signals. Якщо ні — збережіть diff і виправляйте найраніший failing layer.
Першоджерела та документація
Кожне змінне твердження про пошукову систему, браузер, інтерфейс або технічну поведінку в матеріалі прив’язане до актуального першоджерела.
Потрібна допомога з діагностикою та впровадженням?
Metricum Lab може простежити crawl, server-response, rendering та indexation evidence для representative route types і перетворити findings на пріоритизовані fixes з acceptance criteria та post-release verification.
Переглянути Technical SEO services